Python 函数
一、函数定义
1.1 默认值参数
为参数指定默认值是非常有用的方式。调用函数时,可以使用比定义时更少的参数
def ask_ok(prompt, retries=4, reminder='Please try again!'):
    while True:
        reply = input(prompt)
        if reply in {'y', 'ye', 'yes'}:
            return True
        if reply in {'n', 'no', 'nop', 'nope'}:
            return False
        retries = retries - 1
        if retries < 0:
            raise ValueError('invalid user response')
        print(reminder)
重要警告:默认值只计算一次。默认值为列表、字典或类实例等可变对象时,会产生与该规则不同的结果。例如,下面的函数会累积后续调用时传递的参数
举个例子:
def f(a, L=[]):
    L.append(a)
    return L

print(f(1))
print(f(2))
print(f(3))
输出结果如下:
[1]
[1, 2]
[1, 2, 3]
不想在后续调用之间共享默认值时,应以如下方式编写函数:
def f(a, L=None):
    if L is None:
        L = []
    L.append(a)
    return L
1.2 关键字参数
def parrot(voltage, state='a stiff', action='voom', type='Norwegian Blue'):
    print("-- This parrot wouldn't", action, end=' ')
    print("if you put", voltage, "volts through it.")
    print("-- Lovely plumage, the", type)
print("-- It's", state, "!")函数调用时,关键字参数必须跟在位置参数后面。所有传递的关键字参数都必须匹配一个函数接受的参数(比如,actor 不是函数 parrot 的有效参数),关键字参数的顺序并不重要。这也包括必选参数,(比如,parrot(voltage=1000) 也有效)。不能对同一个参数多次赋值.
1.3 特殊参数
def f(pos1, pos2, /, pos_or_kwd, *, kwd1, kwd2):
      -----------    ----------     ----------
        |             |                  |
        |        位置或关键字   |
        |                                - 仅限关键字
         -- 仅限位置
/ 和 * 是可选的。这些符号表明形参如何把参数值传递给函数:位置、位置或关键字、关键字。关键字形参也叫作命名形参。
- 位置或关键字参数函数定义中未使用
/和*时,参数可以按位置或关键字传递给函数。 - 仅位置参数此处再介绍一些细节,特定形参可以标记为 仅限位置。仅限位置 时,形参的顺序很重要,且这些形参不能用关键字传递。仅限位置形参应放在
/(正斜杠)前。/用于在逻辑上分割仅限位置形参与其它形参。如果函数定义中没有/,则表示没有仅限位置形参。/后可以是 位置或关键字 或 仅限关键字 形参。 - 仅限关键字参数把形参标记为 仅限关键字,表明必须以关键字参数形式传递该形参,应在参数列表中第一个 仅限关键字 形参前添加
*。
如果单独出现星号 * ,则星号 * 后的参数必须用关键字传入;
/ 前仅限位置、/ 后位置或者关键字
以下用例决定哪些形参可以用于函数定义:
def f(pos1, pos2, /, pos_or_kwd, *, kwd1, kwd2):说明:
- 使用仅限位置形参,可以让用户无法使用形参名。形参名没有实际意义时,强制调用函数的实参顺序时,或同时接收位置形参和关键字时,这种方式很有用。
- 当形参名有实际意义,且显式名称可以让函数定义更易理解时,阻止用户依赖传递实参的位置时,才使用关键字。
- 对于 API,使用仅限位置形参,可以防止未来修改形参名时造成破坏性的 API 变动。
1.4 任意实参列表
调用函数时,使用任意数量的实参是最少见的选项。这些实参包含在元组中(详见 元组和序列 )。在可变数量的实参之前,可能有若干个普通参数:
def write_multiple_items(file, separator, *args):
    file.write(separator.join(args))
variadic 参数用于采集传递给函数的所有剩余参数,因此,它们通常在形参列表的末尾。*args 形参后的任何形式参数只能是仅限关键字参数,即只能用作关键字参数,不能用作位置参数:
def concat(*args, sep="/"):
    return sep.join(args)

concat("earth", "mars", "venus")
'earth/mars/venus'
concat("earth", "mars", "venus", sep=".")
'earth.mars.venus'
1.5 解包实参列表
函数调用要求独立的位置参数,但实参在列表或元组里时,要执行相反的操作。例如,内置的 range() 函数要求独立的 start 和 stop 实参。如果这些参数不是独立的,则要在调用函数时,用 * 操作符把实参从列表或元组解包出来:
list(range(3, 6))            # 附带两个参数的正常调用
[3, 4, 5]
args = [3, 6]
list(range(*args))            # 附带从一个列表解包的参数的调用
[3, 4, 5]
同样,字典可以用 ** 操作符传递关键字参数:
def parrot(voltage, state='a stiff', action='voom'):
    print("-- This parrot wouldn't", action, end=' ')
    print("if you put", voltage, "volts through it.", end=' ')
    print("E's", state, "!")

d = {"voltage": "four million", "state": "bleedin' demised", "action": "VOOM"}
parrot(**d)
-- This parrot wouldn't VOOM if you put four million volts through it. E's bleedin' demised !
二、函数调用
2.1 函数调用的本质:对象调用协议
在 Python 中,函数是一等对象(First-Class Object),def 只是创建了一个函数对象:
def greet(name):
    return f"Hello, {name}"

print(type(greet))  # <class 'function'>
print(id(greet))    # 函数对象在堆内存中的地址
调用操作 () 是语法糖,底层触发 __call__ 方法:
# greet("Alice") 实际上等价于:
greet.__call__("Alice")
这意味着你可以:
# 1. 把函数当变量传递
say_hello = greet
say_hello("Bob")  # 调用的是同一个函数对象

# 2. 函数作为参数(回调)
def execute(func, arg):
    return func(arg)  # 内部调用传入的函数

execute(greet, "World")

# 3. 函数作为返回值(闭包/工厂函数)
def make_multiplier(n):
    def multiplier(x):
        return x * n
    return multiplier  # 返回函数对象

double = make_multiplier(2)
print(double(5))  # 10,调用返回的函数对象
2.2 调用过程中的内存模型:栈帧(Frame)
每次函数调用,CPython 会在调用栈(Call Stack)上创建一个栈帧对象(PyFrameObject)。
栈帧的生命周期
import inspect

def outer():
    x = "外部变量"
    print(f"[Outer] 当前帧: {inspect.currentframe()}")
    inner(x)  # 调用 inner,创建新帧

def inner(y):
    z = "内部变量"
    current = inspect.currentframe()
    print(f"[Inner] 我的帧: {current}")
    print(f"[Inner] 调用者的帧: {current.f_back}")  # 指向 outer 的帧

    # 查看局部变量命名空间
    print(f"[Inner] 局部变量: {current.f_locals}")

outer()
内存布局示意
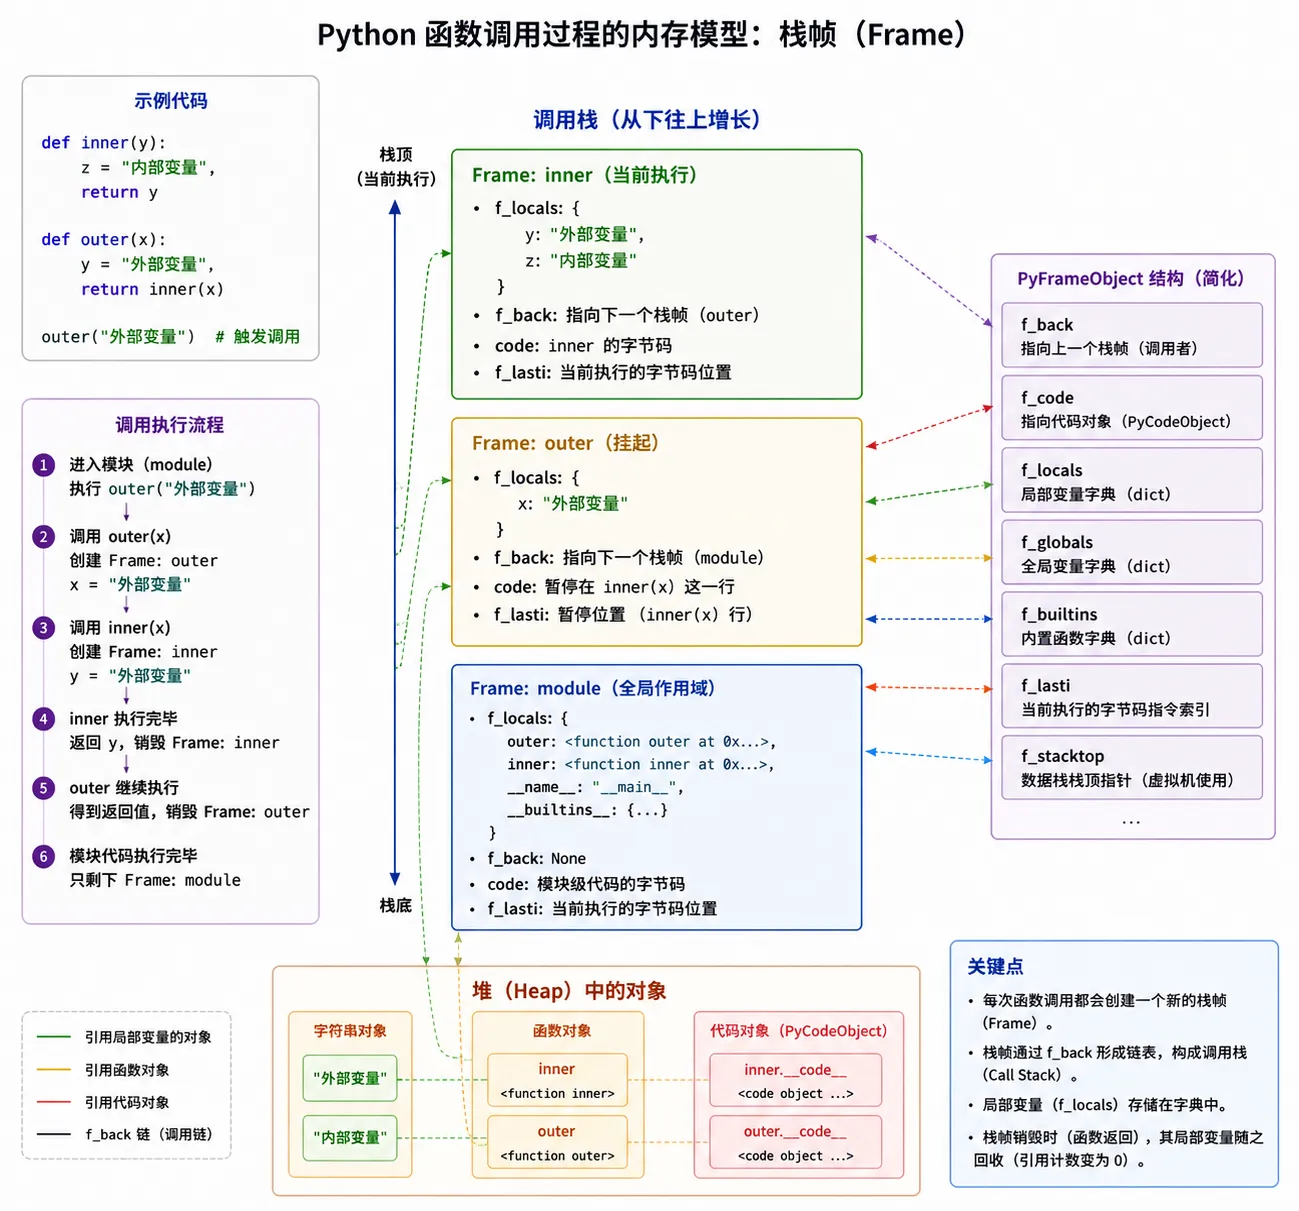
关键特性:
- 每个帧有自己的
f_locals(局部变量字典) - 帧之间通过
f_back指针链接形成调用链 - 函数返回时,帧对象被弹出栈,进入垃圾回收(除非被引用保持,如异常 traceback)
2.3 实参到形参的绑定流程
当你写下 func(a, b) 时,Python 执行的步骤:
阶段 1:实参求值(Left-to-Right)
def compute(x, y):
    return x + y

result = compute(1+1, 2*3)
# 调用时:
# 1. 先求值 1+1 → 2
# 2. 再求值 2*3 → 6
# 3. 然后执行 compute(2, 6)
阶段 2:构建参数元组与字典
def demo(a, b, c=3, *args, d=4, **kwargs):
    pass

# 调用:demo(1, 2, 5, 6, 7, d=8, e=9, f=10)
# 内部转换为:
# 位置参数元组: (1, 2, 5, 6, 7)
# 关键字参数字典: {'d': 8, 'e': 9, 'f': 10}
阶段 3:绑定到形参(CPython 的 ceval.c 逻辑)
# 伪代码模拟 CPython 的参数绑定
def bind_arguments(func, pos_args, kw_args):
    code = func.__code__
    n_args = code.co_argcount          # 位置参数数量 (a, b, c) → 3
    n_defaults = len(func.__defaults__) if func.__defaults__ else 0

    # 1. 创建局部变量字典(即 f_locals)
    locals_dict = {}

    # 2. 绑定位置参数
    for i, name in enumerate(code.co_varnames[:n_args]):
        if i < len(pos_args):
            locals_dict[name] = pos_args[i]
        elif name in kw_args:
            locals_dict[name] = kw_args.pop(name)
        else:
            # 使用默认值(从后往前数)
            default_idx = i - (n_args - n_defaults)
            if default_idx >= 0:
                locals_dict[name] = func.__defaults__[default_idx]
            else:
                raise TypeError(f"缺少必需参数 '{name}'")

    # 3. 处理 *args(剩余位置参数)
    if code.co_flags & 0x04:  # CO_VARARGS
        args_name = code.co_varnames[n_args]
        locals_dict[args_name] = pos_args[n_args:]  # 超出部分打包成元组

    # 4. 处理 **kwargs(剩余关键字参数)
    if code.co_flags & 0x08:  # CO_VARKEYWORDS
        kwargs_name = code.co_varnames[n_args + (1 if code.co_flags & 0x04 else 0)]
        locals_dict[kwargs_name] = kw_args  # 剩余字典直接赋值

    return locals_dict
这里的 locals_dict[name] = value 就是变量名绑定到对象引用的过程。
2.4 参数传递的四种调用风格
风格 1:位置参数(Positional)
def greet(first, last):
    return f"{first} {last}"

greet("Alice", "Smith")  # 按位置绑定:first="Alice", last="Smith"
风格 2:关键字参数(Keyword)
greet(last="Smith", first="Alice") # 按名字绑定,顺序无关风格 3:解包调用(Unpacking)
这是 Pythonic 的写法:
data = ["Alice", "Smith"]
greet(*data)  # 等价于 greet("Alice", "Smith"),序列解包

info = {"first": "Alice", "last": "Smith"}
greet(**info)  # 等价于 greet(first="Alice", last="Smith"),字典解包

# 混合使用(先位置后关键字)
args = ["Alice"]
kwargs = {"last": "Smith"}
greet(*args, **kwargs)  # 合法
风格 4:强制关键字参数(Python 3 特性)
def safe_divide(numerator, denominator, *, strict=False):
    # * 后面的参数必须用关键字指定
    pass

safe_divide(10, 2)           # OK,strict 使用默认值 False
safe_divide(10, 2, strict=True)  # OK
safe_divide(10, 2, True)     # TypeError: 不能按位置传 strict
2.5 可变参数的机制(*args 和 **kwargs)
*args 的底层机制
def flexible(*args):
    print(type(args))  # <class 'tuple'>,不是列表!
    print(args)        # (1, 2, 3)

flexible(1, 2, 3)
为什么用元组?因为:
- 不可变性:函数内部不能意外修改调用者传入的参数序列
- 内存效率:元组比列表更轻量
kwargs 的底层机制
def flexible(**kwargs):
    print(type(kwargs))  # <class 'dict'>
    print(kwargs)        # {'a': 1, 'b': 2}

flexible(a=1, b=2)def trap(**kwargs):
kwargs["list"].append(99) # 修改的是外部列表对象!
external_list = [1, 2]
trap(list=external_list)
print(external_list) # [1, 2, 99],外部被改了!2.6 调用栈与递归
递归的栈帧累积
def factorial(n):
    if n <= 1:
        return 1
    # 这里暂停,创建新帧计算 factorial(n-1)
    return n * factorial(n - 1)

factorial(3)
栈帧增长过程:
factorial(3)  帧3 (n=3, 等待 factorial(2) 返回)
factorial(2)  帧2 (n=2, 等待 factorial(1) 返回)
factorial(1)  帧1 (n=1, 直接返回 1)
              ↑ 返回 1,帧1 弹出
         帧2 计算 2*1=2,返回 2,帧2 弹出
    帧3 计算 3*2=6,返回 6,帧3 弹出
Python 的递归限制(默认 1000 层,防止 C 栈溢出):
import sys
sys.getrecursionlimit()  # 1000
sys.setrecursionlimit(2000)  # 可以修改,但不建议超过 10000
尾递归优化?不存在的
Python 没有尾递归优化(Tail Call Optimization),即使递归是最后一条语句,仍然会创建新栈帧:
def tail_recursive(n, acc=1):
    if n <= 1:
        return acc
    return tail_recursive(n-1, n*acc)  # 尾递归形式,但 Python 不优化

# 依然会栈溢出
解决方案: 显式使用栈或迭代:
def factorial_iter(n):
    result = 1
    for i in range(2, n+1):
        result *= i
    return result
2.7 函数调用的性能考量
调用开销来源
- 栈帧创建:分配 PyFrameObject(约 1-2 微秒)
- 参数绑定:构建 locals 字典,处理默认参数
- 字节码分发:进入新代码对象执行
优化技巧
总结:函数调用的流程图
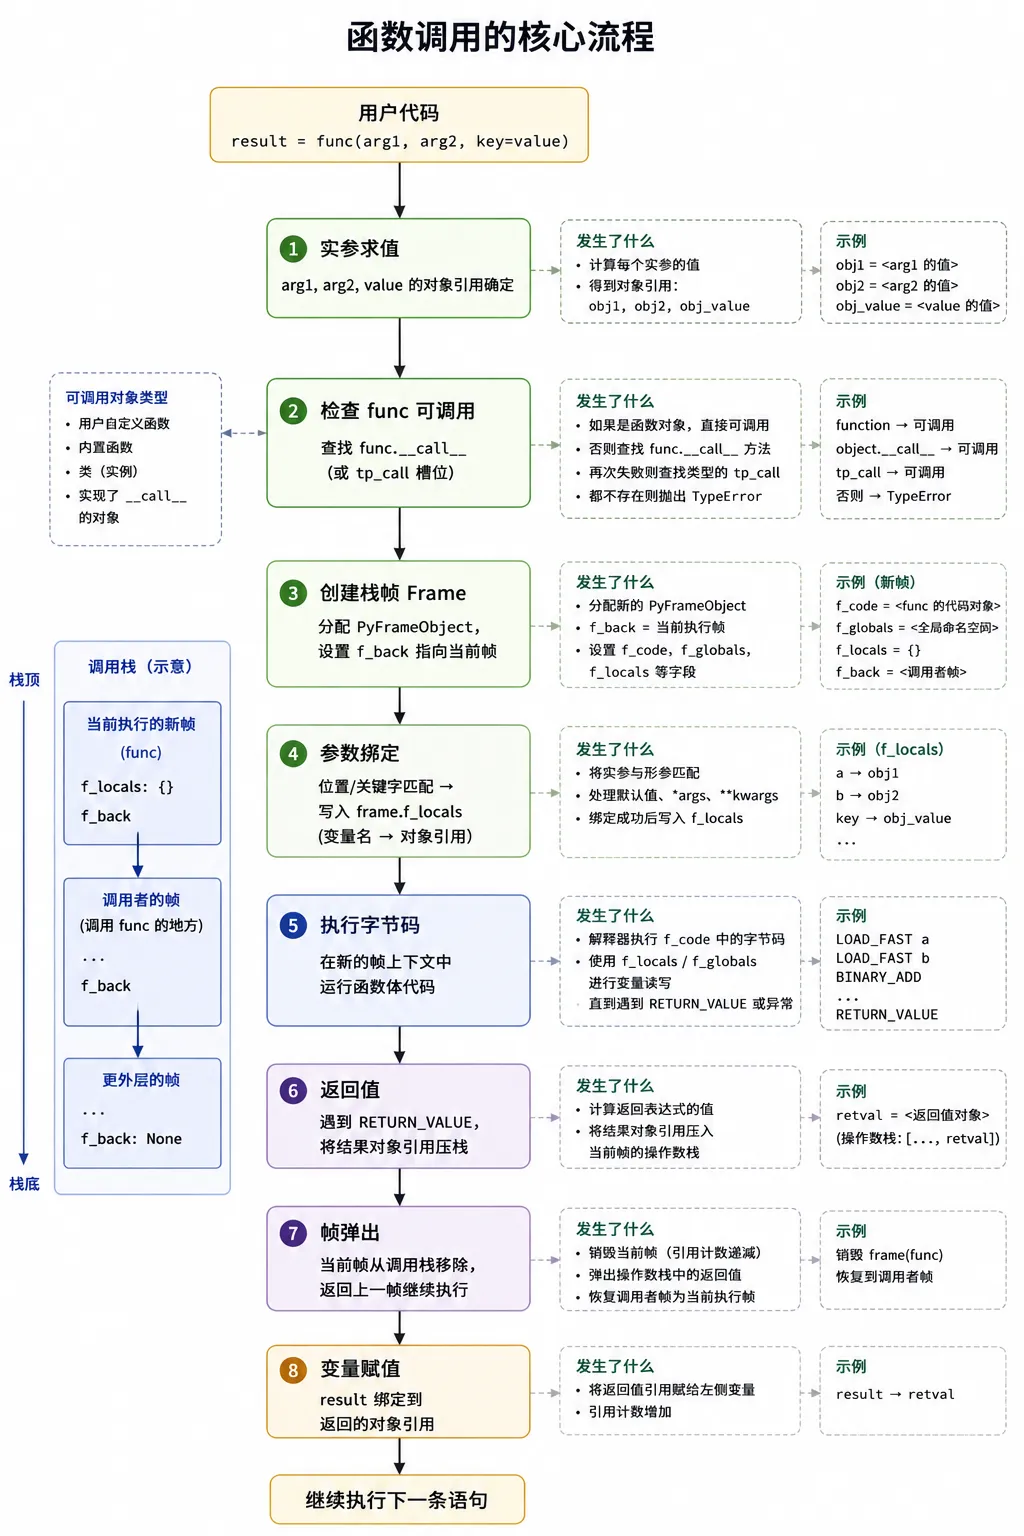
关键记忆点:
- 调用=创建栈帧 + 参数绑定
- 参数传递始终是 " 传对象引用 "(我们之前的结论)
- 函数是一等对象,
()是触发__call__的语法 - 递归深度受限(1000 层),且无尾递归优化
三、Lambda 表达式
lambda 关键字用于创建小巧的匿名函数。lambda a, b: a+b 函数返回两个参数的和。Lambda 函数可用于任何需要函数对象的地方。在语法上,匿名函数只能是单个表达式。在语义上,它只是常规函数定义的语法糖。与嵌套函数定义一样,lambda 函数可以引用包含作用域中的变量:
def make_incrementor(n):
    return lambda x: x + n

f = make_incrementor(42)
f(0)
42
f(1)
43
上例用 lambda 表达式返回一个函数。 另一种用法是传入一个小函数作为参数。 例如,list.sort() 接受排序键函数 key,它可以是一个 lambda 函数:
pairs = [(1, 'one'), (2, 'two'), (3, 'three'), (4, 'four')]
pairs.sort(key=lambda pair: pair[1])
pairs
[(4, 'four'), (1, 'one'), (3, 'three'), (2, 'two')]
适合配合 map()、filter() 和 reduce() 操作序列。